机器人基础模型的发布能力与部署能力并不等同。判断一套系统能否进入真实环境,需要同时考察数据来源、仿真可信度、HIL 接入方式、真机失败分类,以及偏差如何回传至模型与工程参数。本文据此建立一套观察部署成熟度的验证框架。
过去两年,机器人基础模型常以流畅视频、新模型名称、性能数据和任务泛化能力集中呈现。这些材料能够展示能力上限,却不足以证明系统已经具备稳定部署条件。
当模型离开发布页,进入真实机器人、真实传感器、带噪场景和长期维护的产品线,评价标准会从单次表现转向持续运行能力。
下一阶段的竞争,很可能不只发生在模型参数、训练数据量或视频效果上,还将取决于一套可复现、可追踪的 Sim2Real 验证闭环。
一、评价模型,也要评价验证系统
语言模型可以先在离线数据中获得通用能力,再通过产品形态逐步释放。机器人基础模型则直接面对接触、延迟、打滑、过热和传感器安装偏差;边界场景中的微小控制误差,也可能被放大为硬件风险。
因此,评价机器人基础模型需要同时回答以下问题:
- 训练数据覆盖了哪些真实任务和失败样本?
- 仿真环境是否能预测关键物理差异,而不只是生成漂亮画面?
- 控制器、传感器、执行器版本是否被记录进测试数据?
- 真机测试失败后,能否定位到感知、策略、控制、机械、场景还是标注问题?
- 这些失败能否回传,进入下一轮数据、仿真参数、模型训练和验收标准?
这些问题把评价重点从演示效果转向工程证据,也揭示了从单次演示到稳定部署之间的系统性工作。
二、背景:竞争已经不只是模型本身
公开资料显示,机器人基础模型已从单项论文研究扩展为覆盖数据、仿真、训练与部署工具链的系统工程。
NVIDIA 在 Hugging Face 发布 GR00T N1.7,模型卡标注参数规模为 3B(30 亿),主版本为 Isaac GR00T N1 系列;Isaac Sim 与 Isaac Lab 把基础模型、仿真、训练和机器人开发工具链纳入同一生态。值得关注的是这种组合关系:模型、合成数据、仿真训练与机器人开发工具链正在形成连续的工程路径。[1][2]
Open X-Embodiment / RT-X 把问题推进到数据层,组织跨机器人本体、跨任务的数据和模型实验。Open X-Embodiment 论文 v9 摘要披露,跨本体数据来自 22 种机器人本体、21 个机构,覆盖 527 种技能、160,266 个任务。这组数据说明,机器人基础模型的泛化能力首先受本体差异和任务差异约束。[3]
DROID 更接近真实世界的数据条件。项目页和论文披露,它收集了大规模、分布式的真实机器人交互数据,包含约 7.6 万条演示、350 小时交互、564 个场景、86 个任务(v2)。其价值不仅在规模,也在采集方式:真实场景、真实操作者和真实物体状态开始成为模型训练的核心语料。[5]
OpenVLA 为工程团队提供了可进一步适配的 VLA 技术底座。项目页和论文称其为 7B 参数开源视觉-语言-动作模型,并使用 Open X-Embodiment 数据中的约 97 万条机器人 episode 训练。它使更多团队能够基于公开模型接入自身数据、本体和验证门禁,但并不直接等同于部署能力。[6]
这些项目方向不同,却共同显示出一个变化:机器人智能的竞争正在从单一模型能力,扩展到模型、数据与验证系统的协同能力。
模型本身仍然重要,但缺少工程闭环时,模型也难以证明其真实环境中的稳定性。因此,分析重点不应局限于单个版本,而应关注一项结构性变化:基础模型的竞争正在从发布能力转向验证能力。
三、Sim2Real 闭环包含哪些环节
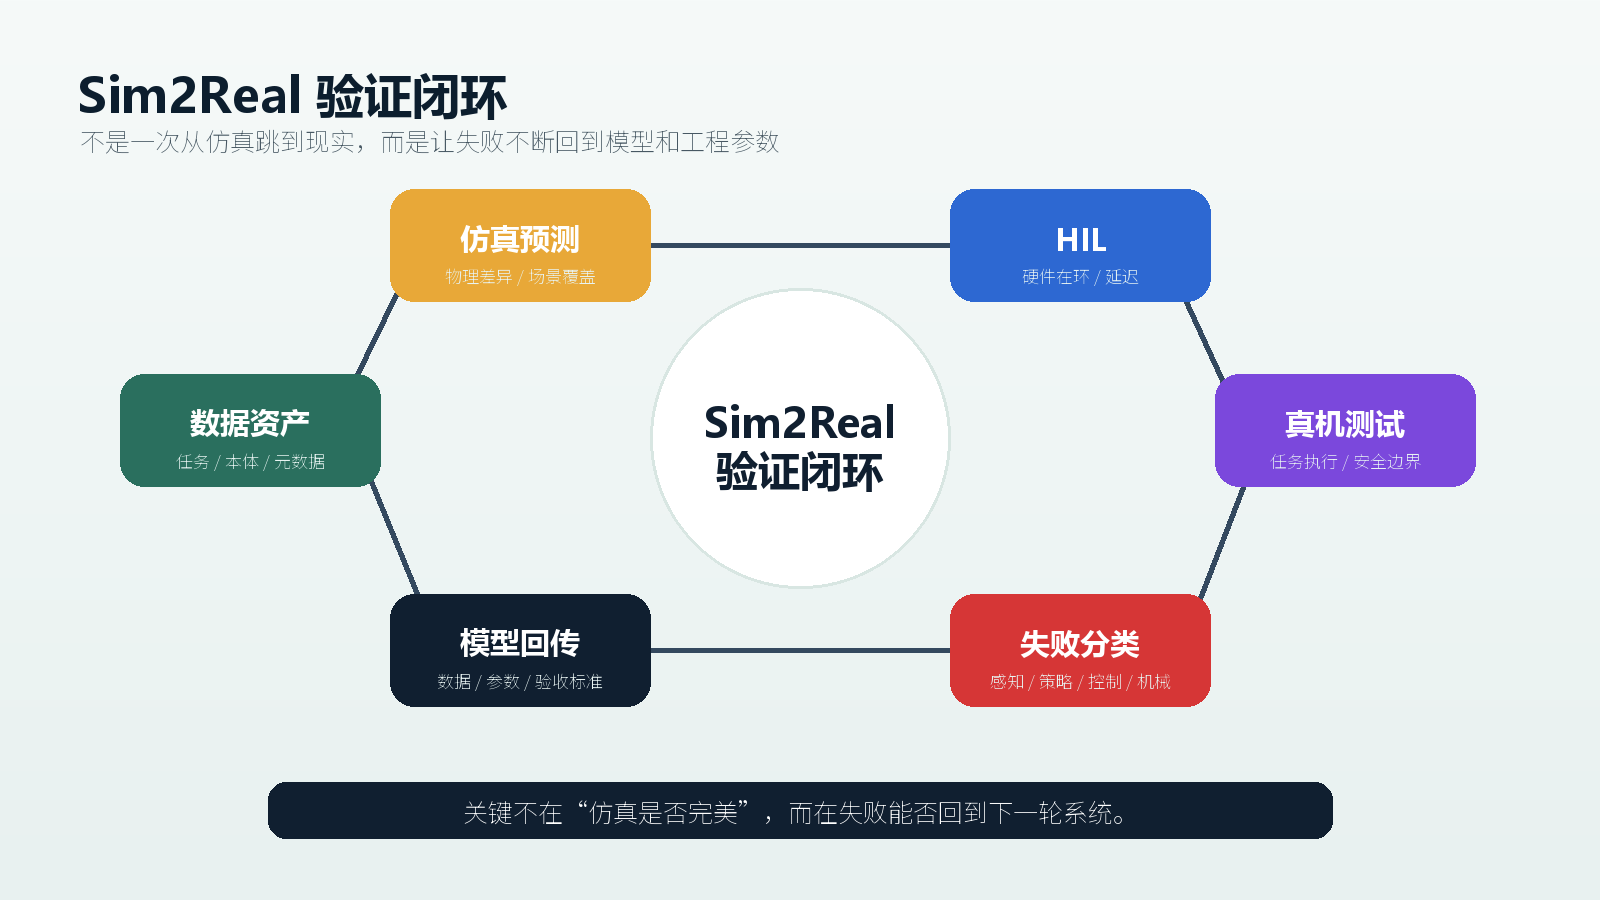
一个有效的 Sim2Real 验证闭环,至少包含五个相互连接的环节。以下内容是本文采用的分析框架,并非行业标准。
第一,数据闭环。 机器人数据应被视为带有上下文的实验记录,而非单纯的视频素材。任务、场景、机器人本体、传感器配置、控制器版本、标定状态、失败原因和人工接管点等元数据一旦缺失,训练样本就可能退化为无法复现的日志。
第二,仿真闭环。 仿真的作用是提出可检验的预测,包括哪些任务可在仿真中排除明显失败,哪些接触、摩擦、延迟、遮挡和执行器限制必须进入模型。无法解释偏差来源的仿真环境,对部署的支持仍然有限。
第三,HIL 闭环。 HIL(hardware-in-the-loop)是一类在真实硬件与仿真模型之间接驳的验证方法,常见形态包括:用真实控制器固件驱动仿真器里的被控对象(用于控制器软件验证),或用仿真器模拟外部环境、真实硬件在回路中响应(用于感知与执行链路验证)。具体配置和收益取决于被验证的子系统,超出本文讨论范围。是否在 HIL 之外叠加数字孪生、是否需要真机参与,要看验证目标,不存在一种"最严格"的统一配置。
第四,真机闭环。 真机测试的价值在于建立失败分类。测试结果需要被分解、定位,并导向数据、仿真参数、训练集、控制参数或验收标准的调整。感知、动作策略、夹爪力控、材料分布和控制延迟等问题只有被结构化记录,才能形成明确的改进方向。
第五,回传闭环。 失败记录需要进一步改变数据采样策略、仿真参数、模型训练集、控制参数或验收标准。完成回传后,前四个环节才从一次性验证转化为持续学习机制。
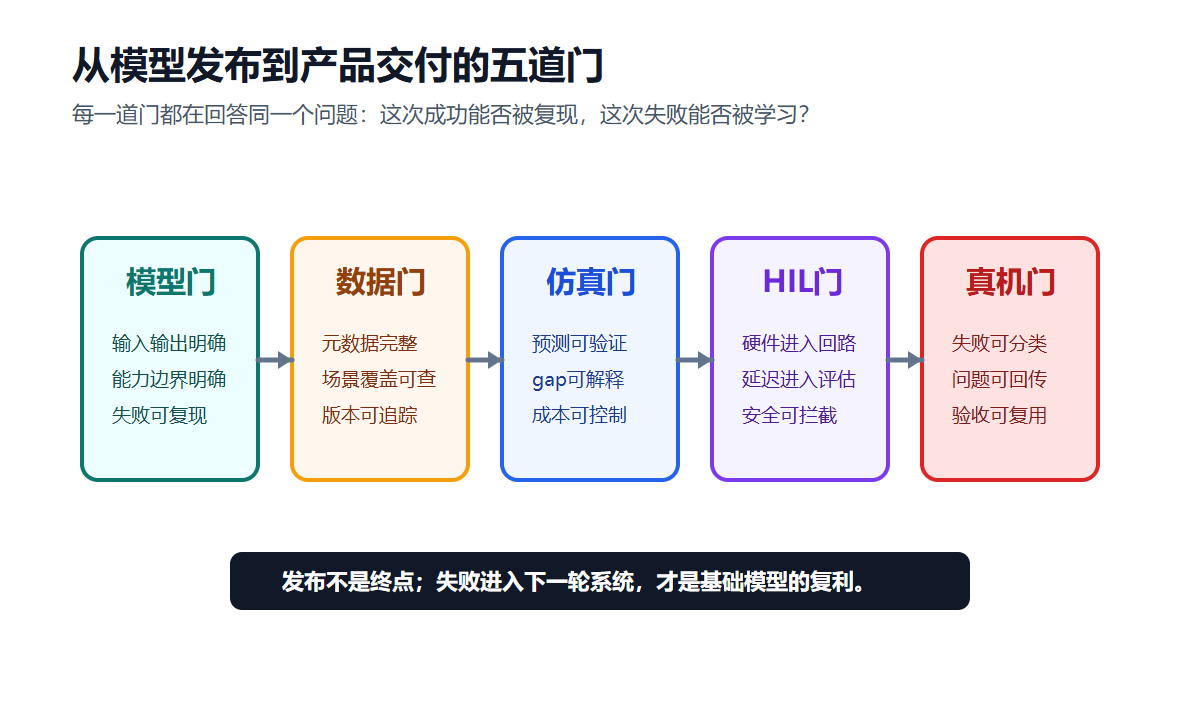
这五个环节共同构成验证闭环,需要算法、测试、硬件与产品团队协同完成。
四、模型能力为何不能替代工程验证
一种常见的反方观点认为,随着机器人基础模型持续增强,部分工程验证可能被模型能力自然吸收;类似大语言模型减少手写规则,机器人模型也可能逐步覆盖感知、规划、控制和泛化问题。
这一判断具有合理性。基础模型能够降低部分手工接口的成本,过去需要拆分为感知、检测、状态机、轨迹规划和控制参数的任务,未来可能由更端到端的策略覆盖。模型越强,系统中的显式规则可能越少。
机器人与纯软件系统的关键差异在于,它直接受物理世界约束。以下四类条件无法由单次模型发布消除。
本体差异。 不同机器人有不同自由度、执行器带宽、关节限制、传感器位置和末端执行器形态。同一个动作,换到另一个本体上,不只是坐标变换,也可能是动力学和接触条件变化。
长尾接触。 机器人任务不仅需要识别物体,还要以合适的力和轨迹完成接触。摩擦、柔顺性、微小形变和物体摆放误差,都会显著增加操作复杂度。
实时约束。 模型输出再聪明,也要穿过传感器、通信、推理、控制器和执行器链路。延迟、抖动、丢包、热管理和算力预算,都会改变策略在真实机器上的表现。
安全责任。 纯软件系统的错误通常可以回滚;机器人在真实空间中的错误可能损坏设备、伤害人员或破坏任务现场。越接近产品,越需要超越平均性能指标的安全验收。
基础模型会改变机器人系统的形态,但不会取消验证。它会减少一部分手写规则,却会放大另一类能力的重要性:数据治理、仿真可信度、测试门禁、失败回传和安全验收。
五、证据链与案例:公开项目提供了什么证据
Open X-Embodiment / RT-X 的价值不只在数据规模,还在于跨本体数据正在成为机器人基础模型的基础设施。论文 v9 摘要中的 22 种机器人本体、21 个机构、527 种技能和 160,266 个任务,共同指向一个难题:模型迁移必须处理不同本体之间的结构与动力学差异。[3]
DROID 表明,真实数据的采集方式与数据规模同样重要。约 7.6 万条演示、350 小时交互、564 个场景、86 个任务(v2),其核心价值在于分布式真实环境,以及由不同操作者、物体状态和环境变化构成的现实边界。[5]
OpenVLA 让更多团队能够参与 VLA 技术路线的适配。7B 参数、约 97 万条机器人 episode 训练,使模型与数据规模进入公开比较;工程难点随之转向团队自身的任务数据、本体适配与验证门禁。[6]
NVIDIA Isaac 生态值得注意的一点,是基础模型、仿真、训练和开发工具链正在被纳入同一套产业方案。若基础模型无法连接仿真与部署工具链,其工程价值仍然难以验证。[1][2]
这些公开项目不能直接推导单一公司的竞争结果,但共同说明:机器人基础模型的能力边界越来越依赖模型之外的工程系统。
将失败转化为下一轮训练与验证的输入,是机器人基础模型形成持续改进能力的关键。
六、反方观点与边界条件
上述判断并不适用于所有研发阶段。
如果团队仍处于早期研究阶段,只验证短任务、算法假设或视觉-动作映射,完整验证闭环的成本可能高于收益。此时应优先保证实验速度,并避免过早建设重型平台。
如果模型仅用于离线数据生成或仿真策略预训练,并不直接控制真实机器人,HIL 与真机闭环的优先级可以相应降低。
外部观察者难以完整了解一家公司的实际验证体系,许多关键能力也不会出现在论文、官网或发布会上。因此,公开材料不足以支持公司成熟度排名,也不能作为完整部署能力的充分证据。
当讨论对象从研究演示进入真实部署,验证闭环会重新成为核心问题,差异主要体现在投入规模与实施深度。
评价标准应与系统所处阶段相匹配:早期研究重视探索效率,产品阶段则需要更严格的验证门槛和责任边界。
七、从成功演示到可复现失败
对机器人基础模型而言,可复现、可分析、可回传的失败记录,比单次成功演示更能说明系统的工程成熟度。
成功演示呈现能力上限;可复现的失败决定系统能否持续迭代。
判断机器人基础模型平台的工程成熟度,可以观察以下五个信号。
第一,它是否把数据当成实验资产,而不是素材仓库。
第二,它是否能说明仿真在哪些问题上可信,在哪些问题上不可信。
第三,它是否有 HIL 或等效的硬件-仿真联合验证路径,让真实控制链路提前暴露问题。
第四,它是否公开失败分类,或至少持续维护这类记录,而不是只展示成功案例。
第五,它是否能把真机问题回传到模型、仿真、控制和验收标准。
这五个信号比演示效果更接近真实部署条件。
机器人基础模型、VLA 与仿真平台仍将持续进步,但在可预见的时间内,机器人依然受物理世界约束。能够将模型发布、数据采集、仿真预测、HIL 验证、真机失败和版本回传连接为可追踪闭环的平台,更有机会把单次能力展示转化为长期稳定运行。
当评价标准从演示效果转向验证质量,机器人基础模型才真正进入工程化阶段。
参考资料
[1] NVIDIA Isaac GR00T N1.7 模型卡:https://huggingface.co/nvidia/GR00T-N1.7-3B
[2] NVIDIA Isaac Sim 与 Isaac Lab:https://developer.nvidia.com/isaac/sim 、https://developer.nvidia.com/isaac/lab
[3] Open X-Embodiment 论文 v9(2025-05-14):https://arxiv.org/abs/2310.08864v9
[4] Open X-Embodiment / RT-X 项目页:https://robotics-transformer-x.github.io/
[5] DROID 数据集与论文:https://droid-dataset.github.io/
[6] OpenVLA 项目页与论文:https://openvla.github.io/